基于数据湖与数据仓的高效数据处理服务 产品功能架构设计实践
引言
在企业数字化转型的浪潮中,数据已成为核心生产要素。面对海量、异构、实时性要求日益提升的数据,如何构建一套既能承载数据湖的灵活性、又能发挥数据仓的规范性,并实现高效数据处理流程的产品功能架构,是数据平台建设的关键挑战。本文聚焦于数据处理服务层,探讨如何围绕数据湖与数据仓设计高效、可扩展、易运维的产品功能架构。
一、数据处理服务的功能定位
数据处理服务是连接数据供给与数据消费的桥梁,承担着数据抽取、清洗、转换、加载、计算、调度与质量保障等核心职责。在产品功能架构中,数据处理服务需同时满足两类诉求:
- 面向数据湖的半结构化/非结构化数据处理:强调原始数据的低成本存储、按需计算与模式灵活性,支持流批一体接入与探索式分析。
- 面向数据仓的规范化建模与高性能分析:强调维度建模、指标口径统一、查询性能优化与事务一致性,支撑BI与报表等高并发场景。
因此,数据处理服务应以“统一调度、分层处理、湖仓协同”为设计原则,形成从数据接入到数据服务化的全链路能力。
二、产品功能架构的分层设计
1. 数据接入层
接入层负责多源异构数据的统一采集,产品功能上支持:
- 多模态连接器:数据库(关系型、NoSQL)、消息队列、文件系统、API、IoT设备等。
- 批量与实时双通道:批量同步用于全量/增量抽取;实时通道基于CDC与流式接入,保障低延迟。
- Schema推导与注册:自动识别源数据结构,并注册至元数据中心,为数据湖的Schema-on-Read与数据仓的Schema-on-Write提供衔接。
- 接入任务编排:可视化配置抽取频率、过滤条件、字段映射与脏数据处理策略。
2. 数据存储层(湖仓协同)
存储层是数据处理服务的基石,产品架构上采用“湖仓一体”的存储抽象:
- 数据湖存储:采用对象存储/分布式文件系统,支持原始数据、清洗后中间数据与归档数据的分区存储,提供表格式管理(如Iceberg/Hudi/Delta Lake),支持ACID、时间旅行与增量读取。
- 数据仓存储:基于MPP数据库或湖上建仓(Lakehouse),按主题域建设事实表与维度表,采用列式存储与分区裁剪提升查询性能。
- 统一元数据服务:集中管理库、表、字段、分区、血缘、标签与权限,实现湖仓元数据双向同步,避免数据孤岛。
3. 数据处理层(核心计算引擎)
处理层是功能架构的核心,围绕“高效数据处理流程”设计以下能力:
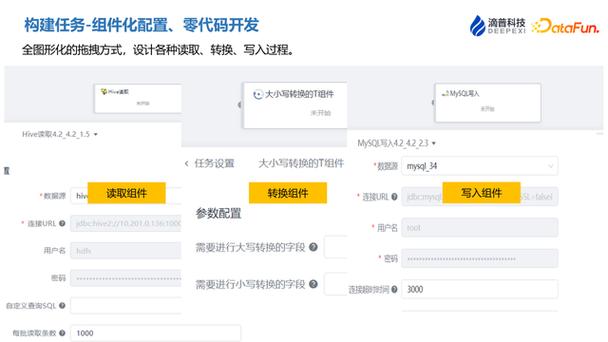
- ETL/ELT编排引擎:支持可视化DAG编排,节点包括数据抽取、字段映射、清洗过滤、聚合计算、关联Join、分流输出等;支持SQL、脚本与自定义算子混合编排。
- 批流一体计算:同一套逻辑可分别以批模式或流模式运行,降低开发与运维成本;实时任务支持Exactly-Once语义与状态管理。
- 增量处理与变更数据捕获:基于CDC与增量快照,实现湖仓表的增量更新与合并(Merge-On-Read/COW),减少全量重算开销。
- 数据质量与校验:内置质量规则(空值率、唯一性、值域、定时波动检测),在数据处理流程中嵌入校验节点,异常数据自动路由至死信队列并告警。
- 任务调度与资源管理:支持依赖调度、周期调度与事件触发;按队列/租户隔离资源,提供弹性伸缩与成本配额管理。
4. 数据服务层
处理后的数据需以服务化方式赋能业务,产品功能包括:
- 逻辑视图与指标层:在数据仓之上构建统一指标语义层,屏蔽底层物理表差异,保障指标口径一致。
- 查询加速:通过物化视图、结果缓存、预聚合与向量化引擎,提升高并发查询响应。
- API与数据产品:将处理结果封装为数据API、数据集与订阅服务,支持权限管控与调用审计。
5. 运维与治理层
贯穿全流程的支撑能力:
- 数据血缘与影响分析:可视化展示表/字段级血缘,辅助变更影响评估。
- 任务监控与告警:实时展示任务运行状态、延迟、资源消耗,支持多渠道告警与自动重试。
- 权限与安全:行级/列级权限、数据脱敏、审计日志,满足合规要求。
三、高效数据处理流程的关键设计
1. 分层处理与职责分离
数据处理流程按“原始层→清洗层→整合层→应用层”分层组织:
- 原始层(ODS):保留原始数据,仅做接入与轻度标准化。
- 清洗层(DWD):完成去重、格式转换、异常过滤与维度关联。
- 整合层(DWS):按主题进行轻度汇总与宽表构建。
- 应用层(ADS):面向具体报表与API的输出层。
每层对应独立的数据处理任务与存储表,便于问题定位、复用与权限隔离。
2. 增量优先、批流融合
为避免全量重算带来的资源浪费,产品功能上强化增量处理能力:
- 数据接入以CDC与增量文件为主;
- 处理环节支持增量合并(Upsert/Delete)与增量物化;
- 调度上支持依赖触发,上游增量产出后自动触发下游增量任务,显著缩短端到端数据就绪时间。
3. 冷热分层与计算下推
针对数据湖中海量历史数据,产品架构支持:
- 按访问频率将数据自动分层至标准存储与低频存储;
- 查询时利用计算下推(谓词下推、列裁剪、分区裁剪)减少I/O;
- 对高频访问的湖表数据,通过物化视图同步至数据仓加速层,实现湖仓协同查询。
4. 可观测与自愈
高效处理流程不仅依赖性能,更依赖稳定性:
- 任务级别记录输入输出行数、耗时、资源峰值与质量指标;
- 对失败任务自动重试并发送告警,支持断点续跑;
- 关键链路提供端到端延迟看板与SLA监控。
四、典型场景与价值
以某零售企业为例,基于上述功能架构建设数据处理服务后:
- 数据接入时效从T+1提升至分钟级,支持实时库存与营销分析;
- 湖仓统一元数据减少了30%的重复开发;
- 增量处理使核心宽表每日计算资源下降约40%;
- 统一指标层消除了报表口径不一致问题,数据可信度显著提升。
五、
数据湖与数据仓并非对立,而是互补。在产品功能架构设计中,以数据处理服务为核心枢纽,围绕接入、存储、处理、服务与治理五个层次构建统一能力,并坚持增量优先、批流融合、湖仓协同与可观测设计,才能真正实现高效的数据处理流程,让数据从“存得起”走向“算得快、用得准、管得住”。随着AI与自动化技术的融入,数据处理服务将向更智能的编排、优化与自愈方向演进,持续释放数据价值。
如若转载,请注明出处:http://www.weshn.com/product/35.html
更新时间:2026-11-03 21:43:14