大数据处理中的Lambda架构与Kappa架构 数据处理服务的架构选择
在大数据处理领域,数据处理服务需要应对海量、高速和多样化的数据流,同时保证低延迟、高吞吐和容错性。Lambda架构和Kappa架构是两种广泛使用的数据处理架构模式,它们各自针对不同的需求场景提供了解决方案。本文将深入探讨这两种架构的原理、优缺点以及适用场景,帮助读者在实际的数据处理服务中做出合理的选择。
Lambda架构
Lambda架构由Nathan Marz提出,旨在同时满足批处理和流处理的需求,提供低延迟的实时视图和准确的批处理视图。其核心思想是将数据处理分为三层:批处理层(Batch Layer)、速度层(Speed Layer)和服务层(Serving Layer)。
批处理层
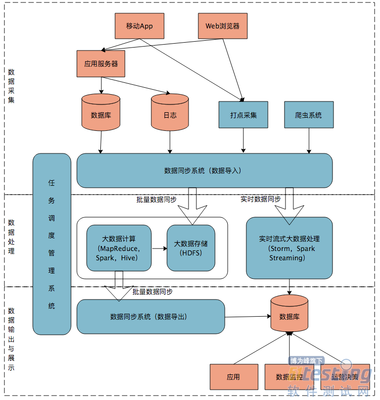
批处理层存储不可变的主数据集(Master Dataset),并预先计算批处理视图(Batch Views)。这一层通常使用分布式文件系统(如HDFS)存储原始数据,并利用MapReduce、Spark等批处理引擎进行全量计算。批处理层保证了数据的准确性和完整性,但延迟较高。
速度层
速度层处理实时数据流,仅计算最近的数据增量,生成实时视图(Real-time Views)。这一层通常使用流处理框架(如Storm、Flink)来补偿批处理层的高延迟,提供低延迟的查询结果。速度层的数据处理是增量的,因此可能存在一定的误差。
服务层
服务层将批处理视图和实时视图合并,对外提供统一的查询接口。查询时,服务层会合并两个视图的结果,以提供完整的视图。服务层通常使用数据库(如HBase、Cassandra)来存储视图并支持快速查询。
Lambda架构的优点在于其容错性和准确性:批处理层可以重新计算历史数据以纠正错误,速度层则保证了实时性。Lambda架构的缺点也很明显:需要维护两套代码(批处理和流处理),增加了开发和运维的复杂度;合并视图可能带来额外的延迟。
Kappa架构
Kappa架构由Jay Kreps提出,是对Lambda架构的简化。其核心思想是只使用流处理系统来处理所有数据,通过重放历史数据来实现批处理的效果。Kappa架构去除了批处理层,只保留速度层和服务层(或直接由流处理系统提供查询)。
在Kappa架构中,所有数据都被视为流,通过消息系统(如Kafka)持久化存储。当需要重新计算或修正数据时,只需从消息系统中重放数据流,使用相同的流处理代码进行处理。这样,Kappa架构仅需维护一套代码,大大降低了复杂度。
Kappa架构的优点包括:架构简单,统一了批处理和流处理的代码;减少了系统组件,降低了运维成本;通过重放机制保证了数据的可重复处理。Kappa架构也面临挑战:对于大规模历史数据的重放,可能需要较高的吞吐量和存储成本;流处理系统需要支持 exactly-once 语义以保证数据准确性;对于复杂的批处理任务,流处理可能不如批处理引擎高效。
比较与选择
Lambda架构和Kappa架构各有优劣,选择取决于具体的业务需求和技术栈。
- 数据准确性要求:如果业务对数据准确性要求极高,且需要处理大量历史数据,Lambda架构的批处理层可以提供更可靠的结果。
- 实时性要求:两者都能提供低延迟的实时视图,但Kappa架构通过统一的流处理简化了实时管道。
- 开发与运维复杂度:Kappa架构只需维护一套代码,更适合快速迭代和简化运维;Lambda架构需要维护两套代码,复杂度较高。
- 历史数据处理:Lambda架构的批处理层擅长处理全量历史数据;Kappa架构通过重放流来处理历史数据,需要流处理系统具备高吞吐和持久化能力。
- 技术成熟度:Lambda架构已有较多实践案例,批处理和流处理技术成熟;Kappa架构依赖于先进的流处理系统(如Flink)和消息系统(如Kafka),对技术栈要求较高。
在实际的数据处理服务中,许多组织根据场景混合使用两种架构。例如,对于关键业务指标,采用Lambda架构保证准确性;对于实时性要求高的场景,采用Kappa架构简化流程。随着流处理技术的进步(如Flink的批流统一),Kappa架构的应用越来越广泛。
结论
Lambda架构和Kappa架构是大数据处理中两种重要的架构模式。Lambda架构通过批处理和流处理的结合,提供了准确和实时的视图,但复杂度较高;Kappa架构通过统一的流处理简化了架构,适合实时性要求高、历史数据可重放的场景。在选择架构时,数据处理服务需要权衡准确性、实时性、复杂度和成本等因素,根据业务需求做出合理决策。随着批流融合技术的发展,两种架构可能会进一步演进,为大数据处理提供更高效的解决方案。
如若转载,请注明出处:http://www.weshn.com/product/37.html
更新时间:2026-11-03 11:09:05