搭建集群服务器 实现高效稳定的数据处理服务
引言
在数字化时代,数据已成为核心资产,而数据处理服务则是挖掘数据价值的关键。面对海量数据与高并发需求,单台服务器往往难以兼顾性能与可靠性。搭建集群服务器,通过多节点协同工作,成为实现高效、稳定数据处理服务的必然选择。本文将系统性地介绍集群服务器的搭建要点,涵盖架构设计、硬件选型、软件配置、性能优化与运维管理,帮助您构建一个兼具高效率与高稳定性的数据处理平台。
一、集群架构设计:确定方向
集群架构是搭建的基石。根据数据处理任务的特点(如批处理、流计算、高并发查询),可以选择不同的架构模式:
- 负载均衡集群:通过前端分发器(如Nginx、LVS)将请求均匀分配到后端多个处理节点,适用于Web服务、API网关等场景,可显著提升吞吐量并避免单点过载。
- 高可用集群:采用主备或双活模式,借助Keepalived、Pacemaker等工具实现故障自动切换,保障服务连续性,适合对可用性要求极高的核心数据处理服务。
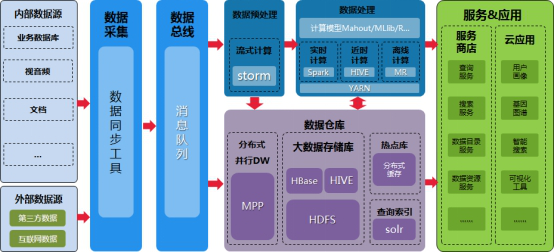
- 分布式计算集群:如Hadoop、Spark、Flink等框架,将计算任务分解到多个节点并行执行,适用于大规模数据批处理与实时流计算。
- 存储集群:如Ceph、GlusterFS或分布式数据库集群,提供高可靠、可扩展的数据存储底座。
在实际设计中,通常采用混合架构:例如“负载均衡+高可用+分布式计算”组合,既保证请求分发效率,又确保计算层容错。建议从业务需求出发,明确性能指标(QPS、延迟、数据量),避免过度设计。
二、硬件选型与网络规划:夯实基础
硬件与网络直接决定集群的潜力。选型原则如下:
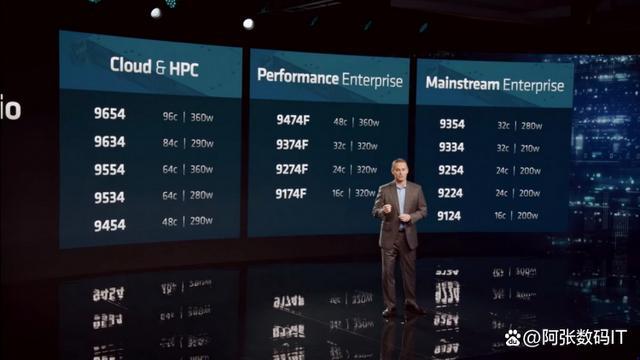
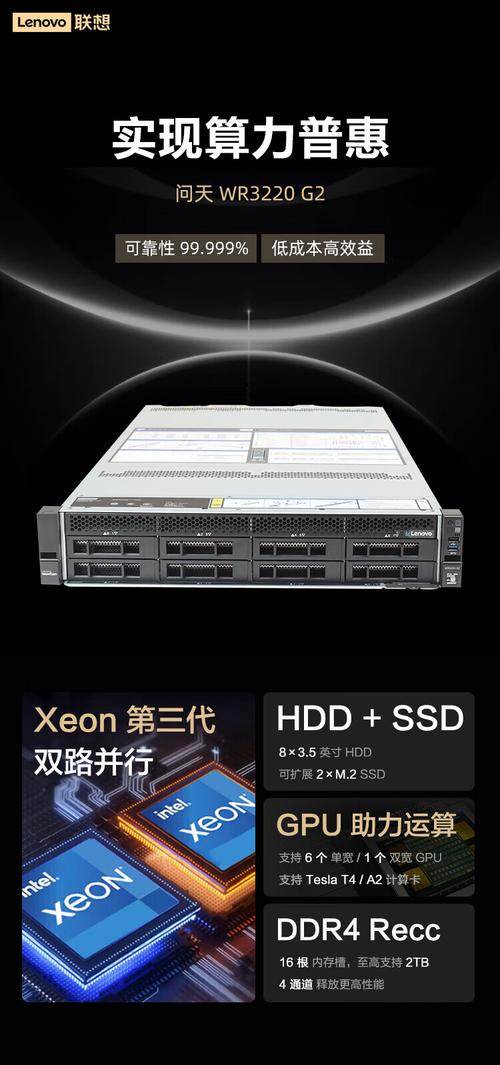
- 服务器节点:根据计算密集型或I/O密集型任务选择CPU与内存配比。处理大数据时,建议多核CPU、大容量内存(≥64GB)、高速SSD(NVMe)以提升I/O性能。节点数量至少3台(避免脑裂),并预留扩展能力。
- 网络设备:万兆以太网是集群内部通信的标配,对于分布式存储与计算,可考虑InfiniBand或RDMA以降低延迟。交换机需支持链路聚合与冗余。
- 存储方案:本地磁盘用于缓存与临时数据,集中式存储(SAN/NAS)或分布式存储用于持久化数据。务必规划RAID级别(如RAID10)保障数据安全。
- 电源与机架:采用双电源冗余,机架布局考虑散热与布线。
网络拓扑建议采用 Spine-Leaf 架构,确保节点间通信的低延迟与高带宽。为管理网络、业务网络与存储网络划分独立VLAN,提升安全性与可维护性。
三、软件环境配置:统一与自动化
一致的软件环境是集群稳定运行的前提。
- 操作系统:选择稳定版本(如CentOS Stream、Ubuntu LTS),统一内核参数(如文件描述符数、TCP缓冲区)。所有节点时间同步(NTP/Chrony)。
- 集群管理工具:使用Ansible、SaltStack或Puppet实现配置批量下发与状态管理。利用Docker/Kubernetes容器化部署数据处理服务,提升环境一致性与弹性伸缩能力。
- 资源调度:若采用Kubernetes,可通过命名空间与资源配额限制各服务的CPU/内存使用;若采用传统物理集群,可使用Slurm、YARN等调度器管理计算任务。
- 共享存储:配置NFS或CephFS为集群提供共享文件系统,便于数据在节点间流转。
四、数据处理服务部署与性能优化:释放效能
针对数据处理服务的特殊性,需在部署与优化上精雕细琢:
- 服务部署:将数据处理服务(如数据ETL、实时计算、API服务)容器化,利用Kubernetes的Deployment与Service实现高可用与负载均衡。对于有状态服务,使用StatefulSet并配合持久卷。
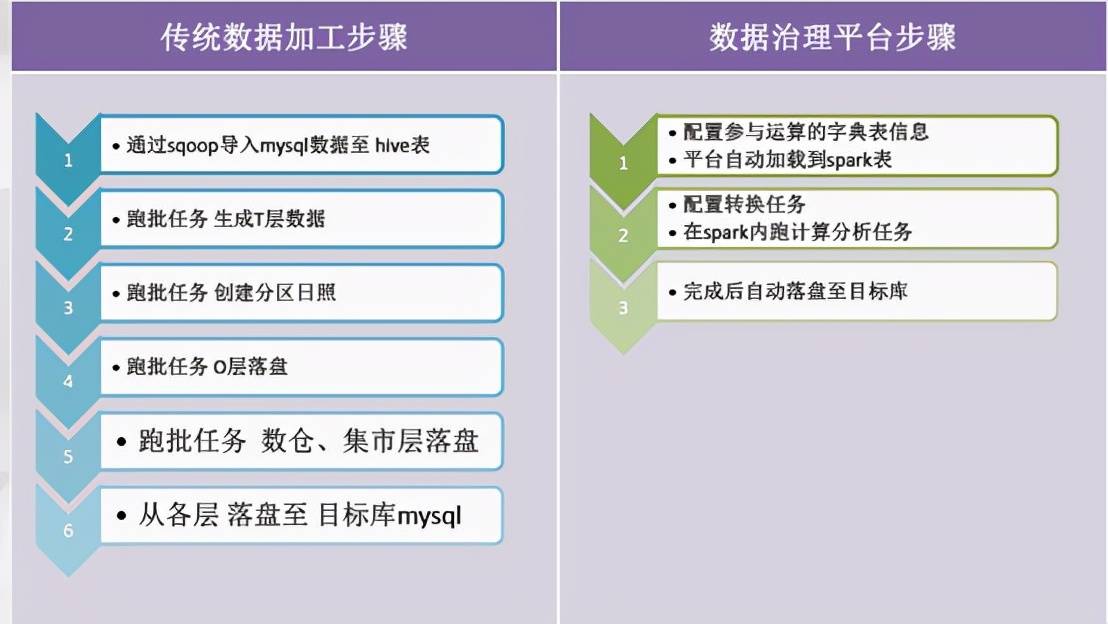
- 数据分片与并行:在分布式计算中,合理设置分片大小与并行度,避免数据倾斜。例如Spark中调整
spark.sql.shuffle.partitions,Flink中设置合适的并行度。 - 缓存与队列:引入Redis或Memcached缓存热点数据,使用Kafka/RabbitMQ作为数据缓冲队列,平滑流量峰值,提升整体吞吐。
- 数据库优化:读写分离、索引优化、连接池配置(如HikariCP)。对于大规模数据查询,考虑列式存储(ClickHouse)或搜索引擎(Elasticsearch)。
- 监控与调优:部署Prometheus+Grafana监控集群资源与业务指标,使用Jaeger实现链路追踪。定期分析慢查询与资源瓶颈,动态调整参数。
性能测试必不可少:通过JMeter或wrk模拟负载,验证集群处理能力,并根据结果迭代优化。
五、稳定性与可靠性保障:构建防线
高效必须建立在稳定之上。
- 自愈机制:Kubernetes的健康检查(liveness/readiness探针)与自动重启策略;物理集群可通过systemd或supervisor守护进程。
- 冗余设计:关键组件(如负载均衡器、数据库)无单点,部署多实例;数据多副本存储(如Ceph三副本、Kafka副本因子≥2)。
- 负载均衡策略:使用最少连接、加权轮询等算法,配合健康检查自动剔除故障节点。
- 故障演练:定期模拟节点宕机、网络分区,检验集群自恢复能力,完善应急预案。
六、运维与监控:长效运营
集群上线后,需建立完善的运维体系:
- 监控告警:采集节点CPU、内存、磁盘、网络指标,以及服务QPS、错误率、延迟。设置告警阈值,通过钉钉/邮件实时通知。
- 日志管理:搭建ELK(Elasticsearch、Logstash、Kibana)或Loki日志平台,集中存储与分析日志,快速定位问题。
- 备份与恢复:定期备份配置与数据,制定RTO/RPO目标,并演练恢复流程。
- 容量规划:根据业务增长趋势,提前预测资源需求,动态扩容(云上可结合弹性伸缩组)。
##
搭建集群服务器实现高效稳定的数据处理服务,是一项涉及架构、硬件、软件、运维的系统工程。从前期的架构设计出发,到硬件网络选型、统一的软件环境、精细的性能优化,再到稳定性保障与持续运维,每一个环节都至关重要。遵循本文的指导,结合业务实际持续迭代,您将构建出一个能够应对海量数据挑战、支撑业务快速发展的坚实数据处理平台。
如若转载,请注明出处:http://www.weshn.com/product/2.html
更新时间:2026-11-03 16:54:48