数据处理服务 数据工程的核心支柱与价值释放引擎
在数字经济时代,数据已成为核心生产要素,而数据工程则是将原始数据转化为可用资产的关键学科。数据工程涵盖数据处理、数据分析与数据服务三大环节,其中数据处理服务是承上启下的基石——它将杂乱无章的原始数据转化为高质量、可分析、可服务的数据资产。本文聚焦数据处理服务,探讨其内涵、技术体系、实践模式与发展趋势。
一、数据处理服务的定义与定位
数据处理服务是指对原始数据进行采集、清洗、转换、整合、存储与管理的一系列专业化服务,旨在提升数据质量、保障数据一致性、降低数据冗余,并为上层数据分析与数据服务提供可靠输入。在数据工程体系中,数据处理服务处于“数据就绪”阶段,直接决定了分析结论的可信度与服务输出的有效性。若将数据工程比作一座工厂,数据处理服务便是原材料加工车间,其工艺水平决定了最终产品的品质。
二、数据处理服务的核心内容
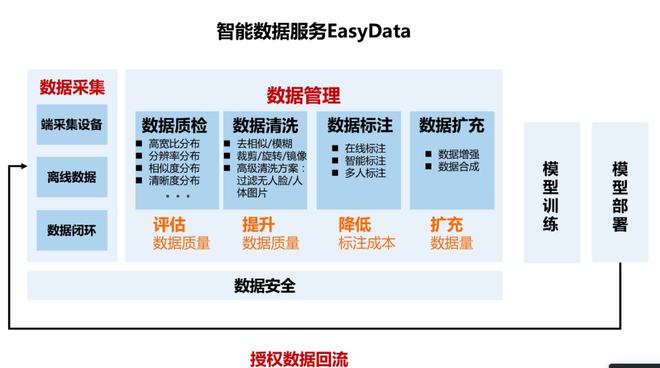
数据处理服务通常包括以下关键环节:
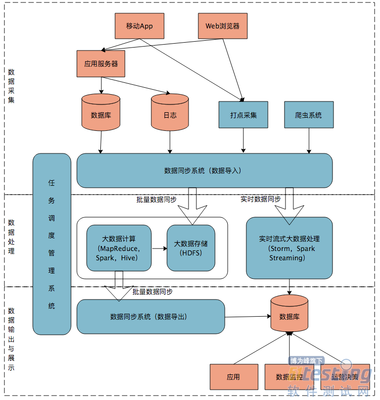
- 数据采集与接入:从业务系统、日志文件、传感器、第三方API等多源异构来源采集数据,支持批量和实时接入方式。
- 数据清洗与质量提升:识别并处理缺失值、异常值、重复记录、格式错误等问题,建立数据质量规则与监控机制。
- 数据转换与标准化:进行数据类型转换、单位统一、编码映射、字段拆分与合并等操作,确保数据口径一致。
- 数据整合与关联:通过实体识别、主数据管理、数据融合等技术,将分散数据整合为统一视图。
- 数据存储与管理:根据数据特征选择合适的存储引擎(关系型数据库、数据湖、数据仓库、NoSQL等),实施分区、索引、生命周期管理等策略。
- 数据安全与合规:实施脱敏、加密、访问控制、审计追溯等措施,满足数据安全法规要求。
三、数据处理服务的技术体系
现代数据处理服务依托多元化技术栈:
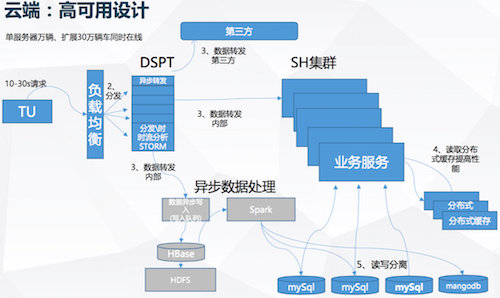
- 批处理技术:以Apache Hadoop、Apache Spark为代表,适用于海量离线数据的ETL(抽取-转换-加载)作业。
- 流处理技术:以Apache Flink、Apache Kafka Streams为代表,支持实时数据管道与低延迟处理。
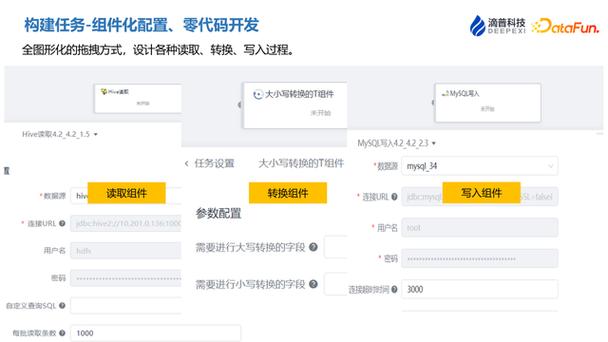
- 数据集成工具:如Apache NiFi、Airbyte、Fivetran,提供可视化数据流转与连接器生态。
- 数据质量平台:如Great Expectations、Apache Griffin,实现质量规则定义、校验与告警。
- 数据编排与调度:如Apache Airflow、Dagster,负责任务依赖管理与执行调度。
- 元数据管理:如Apache Atlas、DataHub,支撑数据血缘、影响分析与资产目录。
云原生数据处理服务(如AWS Glue、Azure Data Factory、阿里云DataWorks)正成为主流,提供弹性、托管、按需付费的处理能力。
四、数据处理服务的实践模式
根据组织规模与业务需求,数据处理服务可采用不同模式:
- 集中式数据平台模式:由中央数据团队统一建设数据处理平台,为各业务线提供标准化服务。适合数据治理要求高、跨部门协同多的组织。
- 分布式数据网格模式:将数据处理责任下放至领域团队,中央平台提供自助式基础设施与规范。适合业务多元、创新迭代快的组织。
- 托管服务模式:依托云厂商或专业服务商提供的托管数据处理服务,降低运维负担,聚焦业务逻辑。适合中小型团队或快速起步场景。
无论采用何种模式,建立清晰的数据处理SLA(服务等级协议)、数据质量度量体系与运维监控机制都是成功的关键。
五、数据处理服务的挑战与趋势
当前数据处理服务面临数据量激增、数据类型多样化、实时性要求提升、隐私合规趋严等挑战。未来发展趋势包括:
- 智能化处理:利用机器学习辅助数据清洗、异常检测与模式识别,降低人工规则维护成本。
- 实时化处理:流批一体架构逐渐普及,实时数据处理成为标配能力。
- 服务化与自治化:数据处理能力以API、数据产品形式对外服务,并借助AIOps实现自愈与自治。
- 安全与隐私增强:隐私计算、联邦学习等技术融入数据处理流程,实现“可用不可见”。
##
数据处理服务是数据工程从“数据可用”走向“数据好用”的核心保障。构建高效、可靠、安全的数据处理服务体系,不仅能够提升数据分析的准确性与效率,更能为数据服务创新奠定坚实基础。组织应将数据处理服务视为战略性能力进行持续投入,以数据工程的整体视角统筹处理、分析与服务,真正释放数据要素价值。
如若转载,请注明出处:http://www.weshn.com/product/27.html
更新时间:2026-11-03 18:36:06